
昨天 Day 26,我們沒有急著選出「命中注定的工作」,而是先用 AI 打開地圖,理解不同職業的日常,再留下兩三個值得繼續驗證的方向。
走到這裡,好像終於可以貼上舊履歷,對 AI 說:「幫我優化一下。」
三十秒後,「協助專題進行」可能又變成:
Successfully collaborated on cross-functional strategic initiatives.
中文大概是:「成功參與跨部門策略合作。」看起來像是公司沒有你就會停止自轉,問題是,別人依然不知道你到底做了什麼。
這是剛畢業或工作經驗不多的人很容易遇到的問題。不是不會寫,而是可以拿來寫的材料還沒有被找出來。
所以 Day 27 不會搜尋大量職缺,也不會產生準備投遞的履歷。今天只完成一件事:把散落在記憶與文件裡的經歷,整理成一座可以反覆使用的「證據庫」。明天 Day 28,才會讓 career-ops 等工具根據真實職缺,從裡面挑選適合的材料。
第一次找工作時,看見別人的履歷寫著五年經驗、帶領十二人團隊、營收成長 35%,再回頭看看自己:
我去年有修機器學習。
整個氛圍突然變得非常安靜。
但 junior 沒有全職經驗,不等於沒有經歷。課程專題、論文、實驗室、實習、社團、志工、助教、營隊、比賽、打工和自己做的小作品,都可能留下材料。
問題是,我們習慣把這些事情統稱為「以前做過」,很少繼續問:當時想解決什麼問題?我負責哪一部分?遇到什麼困難?做過哪些決定?最後留下什麼結果?
因此今天先不要問:「這件事夠不夠厲害?」先問:「這件事實際發生了什麼?」
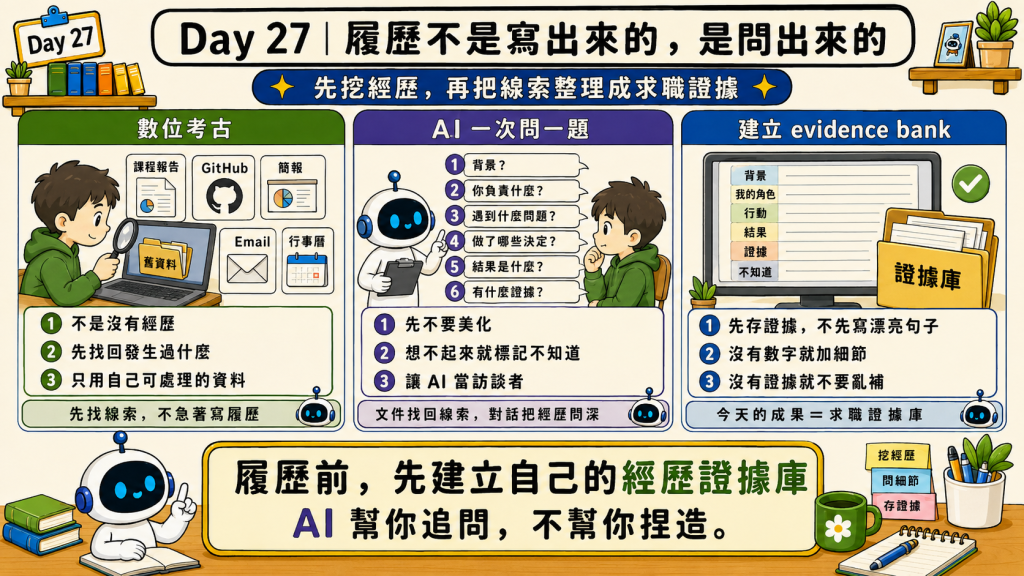
人不一定記得兩年前的專題細節,但電腦可能還留著一些線索:課程報告、簡報、GitHub 紀錄、雲端文件、行事曆、Email,或以前和 AI 討論時留下的對話。
看到一筆「修正時間對齊錯誤」的程式紀錄,可能才想起當時有三種感測器使用不同取樣頻率;翻到期末展示的行事曆,才發現自己不只整理資料,還負責最後的展示。
這些紀錄不會自動變成履歷,卻能幫助我們重建事情經過。履歷準備的第一步,有時候不像寫作,比較像數位考古。
不過,數位考古不是把信箱、實驗室硬碟和所有聊天紀錄整包丟給 AI。文件、研究資料與他人對話可能涉及個資、保密義務和智慧財產。只能使用自己有權處理的內容,必要時先移除姓名、公司資料與敏感數字;不確定能不能使用,就先不要上傳。如果電腦平常有拿來打電動的話,就可以考慮用地端模型來做這件事。
AI 可以幫忙找回記憶,不值得為了一行履歷,順便完成一次資料外洩演練。
找到舊專題後,不要立刻要求 AI 寫履歷。可以先請它根據現有文件,整理專題目標、團隊分工、時間順序、自己的責任、遇到的問題與最後產出。沒有證據的地方標成「不知道」,不要自行補完。
文件可以告訴我們改過哪段程式、交過哪份報告,卻不一定知道為什麼那樣做。是誰先發現問題?試過哪些方法?為什麼放棄其中一個?最後的決定是自己提出,還是老師指定?
這些部分需要透過對話慢慢挖出來:
文件負責找回線索,對話負責把線索問清楚。
這時 AI 最有價值的角色不是寫手,而是訪談者。文字對話可以,語音也可以;關鍵是先讓它問,不要急著讓它產出漂亮句子。
grill-me 改成求職版本Day 21 介紹過 Matt Pocock 的 grill-me Skill。目前它是一個很薄的入口,會呼叫底層的 grilling 方法,持續追問一項計畫、決策或想法,直到雙方不再把重要空白留給猜測。
原本的方法會沿著問題樹,在同一輪詢問目前可以處理的一組問題。今天我們不直接照搬,而是借用 Day 23 的做法,把別人的好方法魔改成適合自己的版本。
求職回憶比較像面談。一次出現二十五題,很容易變成人生申請表,填到第七題就想關掉。所以我會把它改成一次只問一題:使用者回答後,AI 才根據新的資訊決定下一題。
可以打開Codex/Claude Code的app,然後把grill-me的網址貼上去。
再近一步輸入:
我想整理一段可以用在求職中的經歷。請先不要寫履歷,也不要美化內容。一次只問我一個問題,從事情的背景開始,逐步追問我的責任、決定、行動、結果和證據。資訊不足時請繼續問;真的想不起來就標記不知道,不要替我補答案。請你把grill-me修改到具有上述的功能。
這不是原版 grill-me 的正式求職功能,而是依照今天用途改造的版本,可以理解成「求職追問」。也不是一次就可以長成你心中所想的樣態,遇到你覺得有摩擦的地方,就叫agent去修改,迭代到後面就會長成你期待的樣貌。
假設一位學生說:
我做過一個淹水預測的課程專題。
AI 如果立刻把它寫成「開發淹水預測系統」,材料仍然很空。比較有用的下一題是:「這個專題想解決什麼問題?」
回答後再往下問:團隊有幾個人?你負責哪一部分?為什麼由你負責?遇到最麻煩的問題是什麼?試過哪些方法?哪個決定是你做的?最後怎麼知道結果可以使用?有沒有報告、程式或展示可以核對?
下一題由上一個回答決定,才不會把 AI 預先想好的履歷故事硬套到使用者身上。
對 junior 而言,值得留下的不一定是巨大成果,也可能是一個小而真實的決定。Hiring manager 未必期待剛畢業的人替公司多賺五千萬,但會想知道:遇到問題時怎麼想、能不能把事情做完、是否真的碰過困難,還是只跟著教學一步一步照做。
但求職真的是個巨大的混沌現場,有聽過求職者在履歷上寫「半年減肥20公斤」,剛好遇到注重身材管理的用人主管,太想知道減肥的方法,就把人招來面試,就後聊的可喜可賀。這是一個極端的例子,沒有要鼓勵大家都寫上奇特的經驗,然後拼個人品爆發。
履歷教學常說要量化成果,學生很容易開始擔心:「我的課程專題要去哪裡生出營收?」
不用。證據不只一種。
如果有直接結果,可以保留模型準確率、處理時間或活動人數。如果沒有改善百分比,也可以說明規模,例如整理五千筆資料、三人合作八週。沒有漂亮數字,仍可留下程式庫、報告、展示、原型或操作流程等可核對產出。
再不然,至少說清楚具體責任:設計了什麼、建立了什麼、分析了什麼、解決了什麼,以及和誰合作。這些通常比「主動積極、認真負責、熱愛學習」更有區辨力。
沒有數字,就增加細節;沒有證據,就不要增加形容詞。
原文只有「提升資料整理效率」,如果請 AI 寫得更有影響力,它可能熱心地改成「效率提升 40%」。
看起來很棒,但 40% 如果來自 AI 的熱心,就不能放進履歷。
這時應該追問:原本大約花多久?後來花多久?一週執行幾次?有沒有紀錄可以核對?如果真的不知道,就保留不知道。
與其虛構「效率提升 70%」,不如誠實地寫:「建立自動化資料處理流程,取代原本需要人工逐筆整理的步驟。」沒有百分比,但別人知道你做了什麼,而且這件事是真的。
一段經歷問完後,先不要急著壓成一行履歷。今天要建立的是 evidence-bank.md,也就是求職證據庫。
每段經歷可以先留下幾個欄位:事情的背景、自己負責的部分、遇到的問題、做過的決定與行動、結果,以及目前能核對的證據。想不起來或無法確認的內容,也誠實標記出來。
例如:
## 經歷:淹水預測課程專題

### 背景
四人團隊使用歷史降雨資料,嘗試預測淹水風險。

### 我的責任
整理資料、統一時間尺度,並協助模型評估。

### 遇到的問題與決定
不同資料來源的時間解析度不一致。比較處理方式後,決定先統一時間尺度,再處理缺值。

### 結果
完成可重複執行的資料整理流程與期末展示。

### 證據
課程報告、GitHub 紀錄、期末簡報。

### 尚未確認
模型改善幅度,需要回頭查報告。
這份檔案不是正式履歷,也不需要限制在一頁。它比較像所有求職材料共用的原始資料庫。以後想起新細節就補進來,發現原本記錯也可以修正。
如果還記得 Day 7,就會知道格式的選擇取決於下一位接手者是誰。證據庫使用 Markdown,不是為了看起來比較像工程文件,而是因為它還會持續由人修改,下一個出口也仍然是 AI。清楚的標題與固定欄位,能讓人快速找到內容,也讓 AI 比較容易分辨每段經歷的背景、責任、結果、證據與尚未確認之處。
所以,求職版 grill-me 不是只問完一段經歷就結束,也不是準備在一個晚上把整個人生審問完。比較實際的做法,是一次挑一段課程、專題、研究、實習或打工經驗,進行一次數位考古,再把問出的內容整理成 evidence-bank.md 裡的一個經歷模組。
第一段整理完,再處理下一段。隨著不同經歷逐漸加入,這座證據庫才會慢慢長出自己的樣子。
這個過程可能持續好幾天,甚至數十天。因為有些文件需要重新翻找,有些細節需要慢慢回想,也有些成果必須回到原始紀錄才能確認。稍微耐得住性子,一次挖清楚一小段,就已經是在前進。
也不用等到整座證據庫全部完工,才能開始下一步。先完成一兩段最完整、最接近目前方向的經歷,就可以交給明天的 career-ops 試著使用;其他材料之後再繼續補上。
證據庫不是一次寫完的作業,而是一份會跟著經驗持續更新的求職資產。
明天 Day 28,career-ops 才會開始搜尋職缺,讀取不同公司的要求,再讓AI從證據庫挑出相關經歷,製作對應的履歷。今天若急著配對職缺或生成很多版本,等於證據還沒整理好,就先開了一間履歷影印店。
Day 27 的界線很簡單:
今天建立可信的材料;明天才決定這些材料要給誰看。
挑一段課程、專題、實習或打工經驗。先不要想它夠不夠厲害,只問自己:這件事情裡,我實際做了什麼?有哪些文件可以幫我想起來?哪些內容仍然不能確認?
今天想留下的一句話是:
履歷不是從空白文件寫出來的,而是從自己的經歷裡問出來的。


 iThome鐵人賽
 看影片追技術